Tom Alby

Welche Visualisierung für welche Daten?

Daten, Informationen und die daraus zu ziehenden Erkenntnisse zu kommunizieren ist eine wichtige Kompetenz. Datenvisualisierungen sollen es dem Empfänger ermöglichen, Sachverhalte schneller zu verstehen, und so ist es notwendig, dass die Visualisierungsform ausgewählt wird, die das am besten ermöglicht. Auch wenn Microsoft Excel ein Tortendiagramm vorschlägt, so ist es häufig nicht die beste Option, wie man links sieht 🙂

An der Uni wie auch im Job habe ich ständig mit Datenvisualisierungen zu tun. Um die Nerven aller zu schonen, habe ich eine Übersicht gebastelt, inspiriert von der Arbeit von A. Abela:

Die Übersicht wird ständig von mir aktualisiert. Wenn Du Interesse hast, dann melde Dich bei meinem Newsletter an und erhalte sofort die Übersicht (und einmal im Monat ein Update dazu).
Reihennamen in R

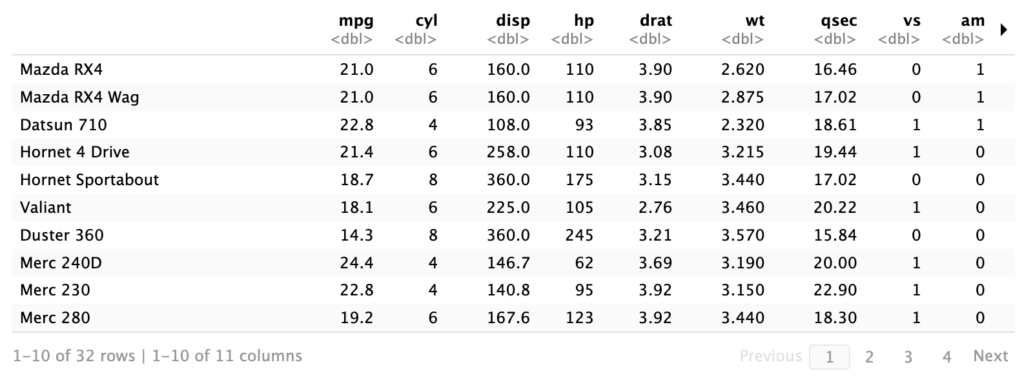
Manche Datensätze nutzen Reihennamen, zum Beispiel der in R enthaltene Datensatz mtcars:

Das ist zwar praktisch, aber suboptimal, wenn man zum Beispiel Autos nach Marken sortieren will. Wie kann man Reihennamen in eine Spalte konvertieren, zum Beispiel mit dem Tidyverse? Ganz einfach:

library(tidyverse)

# mtcars laden und die Reihenamen in eine Spalte verschieben
mtcars_tidy <- mtcars %>%
  rownames_to_column(var = "car_name")

Das Ergebnis sieht dann so aus:

Überschneidungen von ETFs in einem UpSet-Diagramm visualisieren

Heute kommen mal zwei für mich spannende Themen zusammen, nämlich Datenanalyse- und visualisierung sowie Finanzen. Die Wahl der richtigen ETFs füllt unzählige Internetseiten und Finanzmagazin-Artikel, spannend ist hierbei aber auch, welche Überschneidungen ETFs haben. Verglichen hatte ich schon mal den Vanguard FTSE All-World High Dividend Yield UCITS ETF USD Distributing (ISIN: IE00B8GKDB10) und den iShares STOXX Global Select Dividend 100 UCITS (ISIN: DE000A0F5UH1). Ich hatte auch schon die Performance verglichen von diesen beiden und dem VanEck Morningstar Developed Markets Dividend Leaders ETF (NL0011683594) und einem MSCI World ETF (IE00B4L5Y983).

Weiterlesen

ggplot2 und die neue Pipe

Warum funktioniert dieser Code nicht?

mtcars |> ggplot(., aes(x = mpg, y = hp)) + geom_point()

Das Problem mit dem oben genannten Code liegt in der Verwendung des Pipe-Operators (|>), direkt vor ggplot. ggplot2 wird nicht nativ mit der R-spezifischen Pipe (|>) unterstützt, wie hier verwendet. Allerdings funktioniert ggplot2 nahtlos mit dem Magrittr-Pipe (%>%) aus dem dplyr-Paket. Hier ist die korrekte Verwendung:

library(ggplot2)
library(dplyr)

mtcars %>% 
  ggplot(aes(x = mpg, y = hp)) + 
  geom_point()

Alternativ müssen die Daten explizit in ggplot übergeben werden, wie hier:

library(ggplot2)

mtcars |> 
  ggplot(data = ., aes(x = mpg, y = hp)) + 
  geom_point()

Hier stellt der Punkt (.) die Daten dar, die von mtcars in ggplot gepiped werden, und Sie müssen ihn als data-Argument in der ggplot-Funktion spezifizieren.

Die Digital Analytics Association ist Geschichte – und keinen interessiert es

Ein bisschen überraschend war das schon. Ich hatte mit Jim Sterne vor kurzem noch gemailt, als es um den deutschen Ableger ging. Die DAA hatte meinem Webanalyse-Buch auch ein Geleitwort gespendet. Ein bisschen schade ist es schon.

Wer es nicht weiß: Die DAA war früher die WAA, die Web Analytics Association, und sie hat die meistgenutzte Definition von Web Analytics geschaffen. Zwar war diese Definition schon lange nicht mehr auf der Webseite zu finden, aber das hat die meisten Wissenschaftler, die die Zitate aus anderen Papern kopieren, nicht interessiert.

Wie aber kann es sein, dass trotz der Wichtigkeit von Daten eine solche Organisation aufgibt? Es könnte zum Beispiel daran liegen, dass viele zwar Google Analytics & Co installiert haben, aber die Daten gar nicht genutzt werden. In meinem letzten Paper, das leider noch nicht öffentlich ist, kam heraus, dass den meisten Anwendern auch gar nicht klar ist, dass das Einbinden des GA-Codes nicht ausreicht, um datengetrieben zu arbeiten. Und vielleicht liegt es auch ein bisschen an der DAA selbst, dass sie es nicht geschafft hat, die eigene Relevanz deutlich zu machen.

Ich war zuletzt nur noch aus Nostalgiegründen Mitglied. Dabei hatte ich meinen Studierendenstatus ausgenutzt, um die Mitgliedsbeiträge etwas zu senken.

Die Website ist bereits nicht mehr erreichbar.

Von WordPress zu Hugo und wieder zurück

Vor 3 Jahren, zum 15. Geburtstag dieses Blogs, war ich umgezogen von WordPress zu Hugo. Superschnelle Seiten, alles in R, eigentlich eine coole Sache. Aber in der Realität war es nicht so cool. Ich brauchte immer eine R-Umgebung, die ich nicht immer hatte. Git machte mich manchmal wahnsinnig. Und manche Probleme waren einfach nicht nachzuvollziehen. Und so bin ich jetzt wieder umgezogen. Vielleicht kommen nun auch die Rankings wieder zurück, die ich auch verloren hatte nach dem Umzug.

Wie passen Minimalismus und Apple-Produkte zusammen, wenn Apple doch so teuer ist?


Ich nutze seit Mitte der 90er Jahre fast ausschließlich Apple-Produkte. Hin und wieder habe ich Debatten über die Vor- und Nachteile von Apple-Produkten im Vergleich zu ihren Konkurrenten, insbesondere in Bezug auf den Preisunterschied. Und natürlich stellt sich die Frage, ob das überhaupt zusammenpasst, Minimalismus und die Nutzung von Apple-Produkten. Ambivalenz zwischen Designkult und Konsumwiderspruch.

Weiterlesen

Der Zettelkasten als Knowledge Management-System und darüber hinaus

Es gibt ein paar Themen, die mich seit Jahrzehnten beschäftigen, darunter zum Beispiel, wie ich Informationen und Wissen sinnvoll ablegen und wieder abrufen kann, ein Memex halt. In den 90ern war ich ein Fan von Apples HyperCard, seitdem habe ich vieles ausprobiert, und irgendwie hat sich nichts bewährt. Datenformate sind verschwunden (wie das von Apples HyperCard), und auch wenn die technischen Möglichkeiten heute viel breiter sind als damals, habe ich nicht den Eindruck, dass sie das grundlegende Problem gelöst haben. Es gibt keinen Quick Fix, der zu lesende Artikel und Bücher für einen liest und auch noch verstehen lässt. Zusammenfassungs-Services wie Blinkist vertraue ich nicht, ganz abgesehen davon, dass sie mir bei wissenschaftlichen Artikeln auch nicht helfen.

In den letzten Monaten habe ich mich daher wieder einem System zugewandt, das ich auch schon mal in den 90ern genutzt, aber dann für HyperCard aufgegeben hatte: Den Zettelkasten. Nicht irgendeinen Kasten mit Karteikarten, sondern ein Zettelkasten nach dem Luhmann’schen Prinzip. Niklas Luhmann war einer der bedeutendsten Soziologen des 20. Jahrhunderts, der eine unglaubliche Anzahl an wissenschaftlichen Publikationen vorweisen konnte. Sein Zettelkasten, der eigentlich aus mehreren Zettelkästen besteht, enthält ca. 90.000 Zettel und wird an der Universität Bielefeld digitalisiert. Luhmanns Produktivität hat er seinem Zettelkasten-System zugeschrieben, und nach einigen Monaten mit diesem System kann ich das nachvollziehen. Wie funktioniert der Zettelkasten?

Weiterlesen